




Reliability engineering è solo il primo capitolo: governance, FinOps e Developer Experience decidono se l’IA generativa trasforma davvero il ciclo di sviluppo del software. Il prompt è la parte visibile, quella che compare nelle demo, quella che tutti modificano per prima perché è veloce da cambiare e il risultato è immediato. Ma un prompt ben scritto non impedisce a un agente di addebitare due volte a un cliente, di bloccarsi in un loop consumando token, o di prendere una decisione di business che non sarebbe mai dovuta passare dal modello. Il punto di partenza corretto è cercare di scoprire come si rompe. Costruire un agente che funziona in una demo è relativamente facile. Costruire un agente che continua a funzionare quando le API falliscono, il contesto cambia, gli utenti escono dal flusso previsto e il modello prende una decisione inaspettata è un altro problema, di ingegneria, non di prompt. Questa differenza è ciò che separa un prototipo interessante da un sistema che un’azienda può gestire con fiducia. Più tempo si passa lavorando con sistemi agentic, agenti che pianificano, chiamano strumenti, mantengono uno stato lungo più passaggi e prendono decisioni condizionali, più diventa evidente che la maggior parte dell’ingegneria seria non sta dentro il modello. Sta intorno ad esso. Il modello è importante, senza dubbio. Ma l’affidabilità del sistema non può dipendere solo da lui. Ed è proprio questo il punto cieco di molti team che passano da “agente che impressiona al demo day” ad “agente che gira in produzione, con Service Level Agreement, Service Level Objective e Service Level Indicator, con audit, con denaro reale coinvolto”. Prima di qualsiasi ottimizzazione del prompt, vale la pena porsi le domande che davvero mettono alla prova l’architettura, le stesse che qualsiasi reliability engineer farebbe su un sistema distribuito tradizionale, solo che ora applicate a un componente che decide in modo probabilistico.
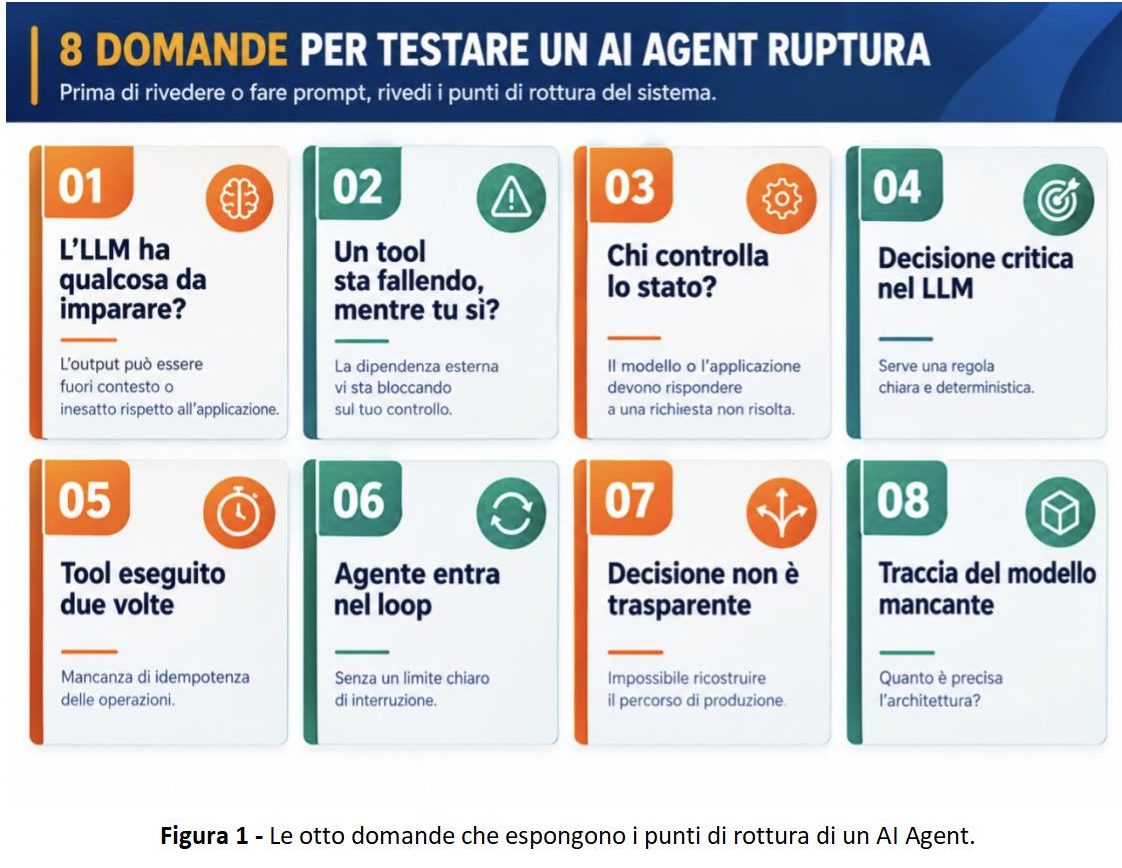
Le 8 domande, una per una
Ognuna di queste domande punta a una componente architetturale specifica. Non sono domande retoriche: sono requisiti di ingegneria travestiti da checklist. Vale la pena analizzarle una per una.
- Cosa succede se l’LLM restituisce qualcosa di inatteso?
Un LLM non restituisce dati: restituisce testo con un’alta probabilità di avere il formato giusto. Questo non equivale a una garanzia. JSON malformato, nome di uno strumento inesistente, parametro del tipo sbagliato, campo obbligatorio omesso, allucinazione di un valore che sembra plausibile: tutto questo è comportamento atteso di un componente probabilistico, non un guasto raro. In pratica, questo significa non eseguire mai un effetto collaterale a partire dall’output grezzo del modello. Tra l’LLM e qualsiasi tool call reale deve esistere uno strato di validazione: output strutturato con schema esplicito, rifiuto deterministico degli output fuori contratto, e un percorso di correzione automatica prima di scalare verso un fallback umano o deterministico.
- E se uno strumento risponde in modo sbagliato, è lento o non disponibile?
Ogni strumento è, in pratica, una dipendenza esterna, e le dipendenze esterne falliscono. La domanda giusta non è “cosa facciamo se l’API cade”, ma “quando l’API cadrà, perché cadrà”.
- Timeout esplicito su ogni chiamata, mai attendere indefinitamente una risposta;
- Retry con backoff esponenziale e jitter, limitato a un numero finito di tentativi;
- Circuit breaker per smettere di colpire una dipendenza già degradata, evitando l’effetto a cascata;
- Fallback definito: risposta in cache, valore di default sicuro, oppure escalation verso un umano, invece di lasciare l’agente bloccato in attesa.
- Chi controlla lo stato dell’esecuzione: il modello o l’applicazione?
Un errore architetturale comune è lasciare che la cronologia della conversazione sia l’unica fonte di stato. Funziona finché il contesto non viene troncato, finché un’iniezione di prompt non riscrive una “memoria” che dovrebbe essere immutabile, o finché due esecuzioni parallele dello stesso agente non perdono la sincronia perché nulla al di fuori del modello sapeva a che punto si trovasse ciascuna. Il pattern più robusto tratta l’esecuzione dell’agente come una macchina a stati esplicita, gestita dall’applicazione: passo corrente, storico delle decisioni, risultato di ogni tool call e punti di checkpoint vivono in uno storage esterno e durevole. Il modello propone la transizione successiva; l’applicazione decide se è valida e la persiste.
- Esiste qualche decisione critica presa dall’LLM che dovrebbe essere deterministica?
Non tutte le decisioni all’interno di un flusso agentic dovrebbero passare dal modello. Ragionamento aperto, interpretazione del linguaggio naturale e sintesi di informazioni sono compiti in cui l’LLM è insostituibile. Calcolo dello sconto, idoneità al rimborso, limite di credito, controllo degli accessi e qualsiasi regola con implicazioni finanziarie, legali o di sicurezza non dovrebbero esserlo. La linea di demarcazione è semplice da enunciare e difficile da mantenere: se la decisione deve essere verificabile, riproducibile byte per byte e difendibile davanti a un regolatore o a un cliente, appartiene a un motore di regole deterministico, non a un’inferenza del modello. L’LLM può suggerire; la policy decide.
- Come impediamo che uno strumento venga eseguito due volte?
Il retry risolve l’indisponibilità temporanea, ma crea anche il rischio opposto: eseguire la stessa azione più di una volta. Un retry automatico dopo un timeout può significare addebitare due volte, inviare due volte un’email o creare due ordini per lo stesso cliente, perché la chiamata originale potrebbe essere andata a buon fine senza che la risposta arrivasse in tempo. La soluzione è l’idempotenza by design: ogni azione con effetto collaterale porta con sé una chiave univoca (derivata dal passo dell’esecuzione, non generata a ogni tentativo), e un registro di idempotenza garantisce che la stessa chiave non produca mai due volte lo stesso effetto, anche in caso di concorrenza o di reinvio.
- Se l’agente entra in loop, esiste un limite chiaro per interrompere l’esecuzione?
Un agente che pianifica e rivaluta può, in condizioni avverse, entrare in un ciclo: chiamare ripetutamente lo stesso strumento, riformulare lo stesso ragionamento senza convergere, o alternarsi tra due stati all’infinito. Senza un limite esplicito, questo non è un bug elegante: è un costo di API che cresce senza controllo e, nei casi peggiori, un effetto collaterale ripetuto in produzione.
- Budget massimo di passi per esecuzione (step budget);
- Tetto di costo/token per sessione, con interruzione automatica al raggiungimento del limite;
- Rilevamento della ripetizione, stesso strumento, stessi parametri, stesso risultato, come segnale di loop;
- Escalation verso una revisione umana come output predefinito quando il limite viene raggiunto, mai il silenzio.
- Riusciamo a ricostruire il percorso completo di una decisione in produzione?
Quando un agente prende una decisione sbagliata, o semplicemente strana, in produzione, la domanda che arriva è sempre la stessa: perché lo ha fatto? Senza observability strutturata, la risposta è sempre un punto interrogativo. Questo richiede tracing per ogni esecuzione, con uno span per ogni chiamata al modello e ogni tool call, logging strutturato del prompt, dell’output e del risultato di ogni strumento con un identificatore di correlazione, e idealmente la capacità di replay: rieseguire la stessa sequenza di decisioni, con gli stessi input, per indagare o validare una correzione. Senza questo, ogni incidente diventa archeologia.
- Se domani cambiamo modello, quanta parte dell’architettura deve cambiare?
I modelli evolvono rapidamente, e l’architettura di un agente non dovrebbe essere legata alle peculiarità di un modello specifico. Se cambiare fornitore o versione richiede riscrivere la logica di orchestrazione, i guardrail e la definizione degli strumenti, l’architettura ha trattato il modello come il centro del sistema, quando invece dovrebbe essere un componente sostituibile. Uno strato di astrazione tra orchestrazione e chiamata al modello, contratti di tool ben definiti e indipendenti dal provider, e soprattutto una suite di valutazione continua, un insieme di test case che gira contro qualsiasi nuovo modello prima che assuma traffico reale, trasformano il cambio di modello da un progetto di mesi a un compito di regressione controllata.
Architettura di riferimento: il modello non è il centro del sistema
Mettendo queste 8 risposte fianco a fianco, emerge un disegno architetturale coerente. L’LLM occupa una posizione specifica e limitata: riceve il contesto e propone la decisione successiva. Tutto ciò che accade prima e dopo questa proposta, validazione, controllo dell’esecuzione, persistenza dello stato, chiamata degli strumenti e registrazione dell’audit, è responsabilità dello strato di orchestrazione, che è codice convenzionale, deterministico e testabile.
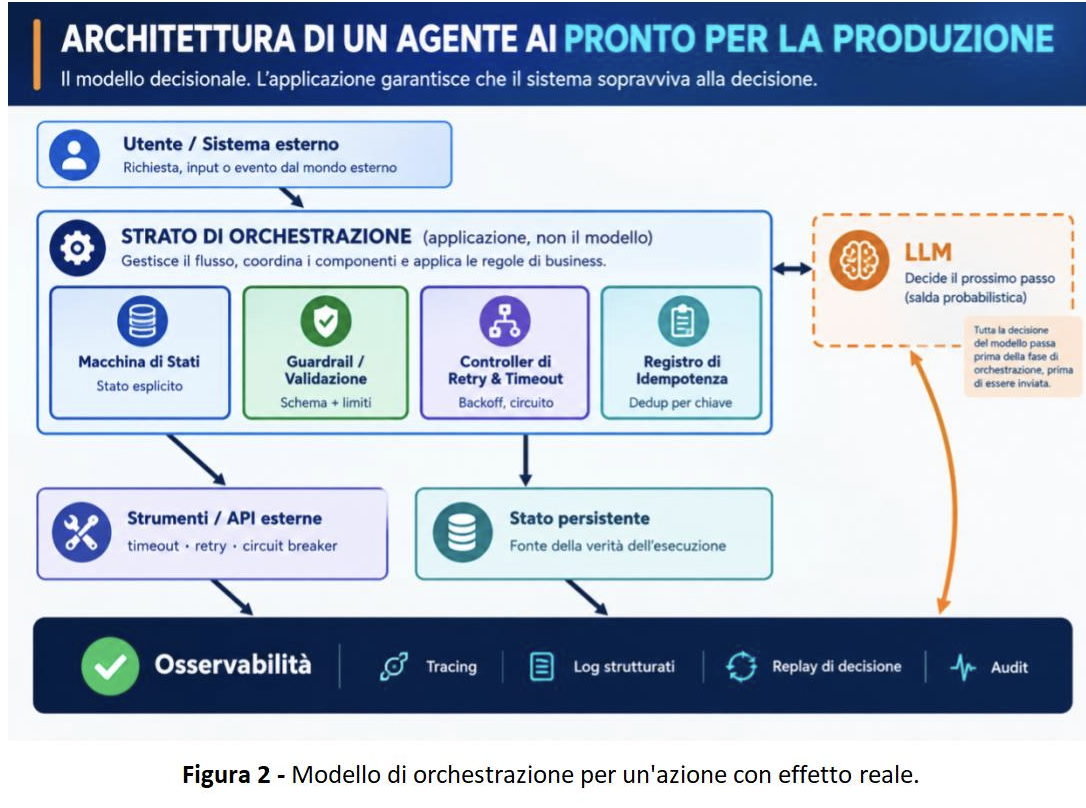
Questa figura risolve, in un colpo solo, diverse delle domande precedenti: lo stato esplicito risponde a chi è il proprietario dell’esecuzione; il controller di retry e timeout risponde a cosa succede quando uno strumento fallisce; il registro di idempotenza risponde a come evitare la duplicazione; e lo strato di observability, presente in ogni scambio, risponde se è possibile ricostruire una decisione dopo i fatti.
Lo stack dell’affidabilità
Mettendo insieme i pattern discussi finora, si può vedere l’affidabilità di un agente come uno stack di livelli: il modello in cima, sottile e sostituibile, e un insieme di garanzie ingegneristiche che sostengono tutto ciò che sta sotto di esso:
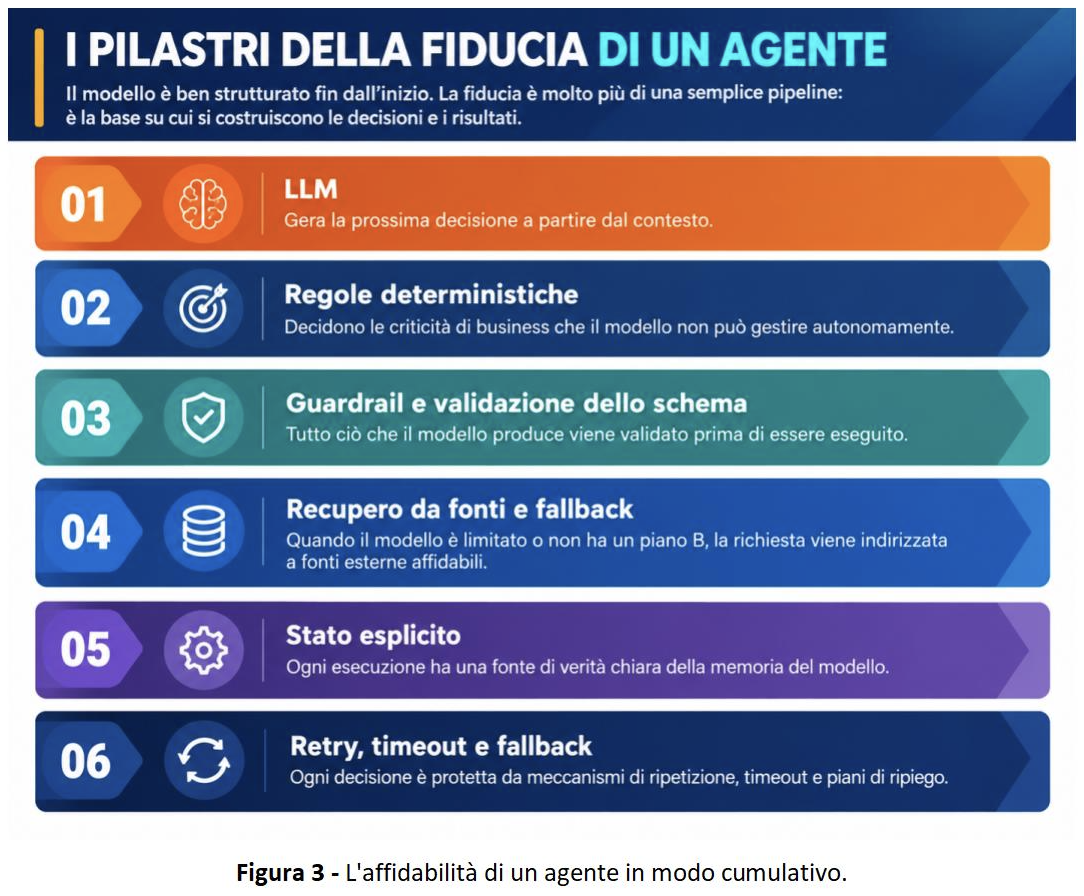
Nessuno di questi livelli è esclusivo dei sistemi con IA: i team di piattaforma e SRE gestiscono retry, idempotenza, circuit breaker e observability da decenni nei sistemi distribuiti convenzionali. La differenza è che, in un agente, il componente in cima allo stack è non deterministico per natura, il che rende tutti i livelli sottostanti non opzionali, ma strutturali.
Da prototipo a sistema: cosa cambia davvero
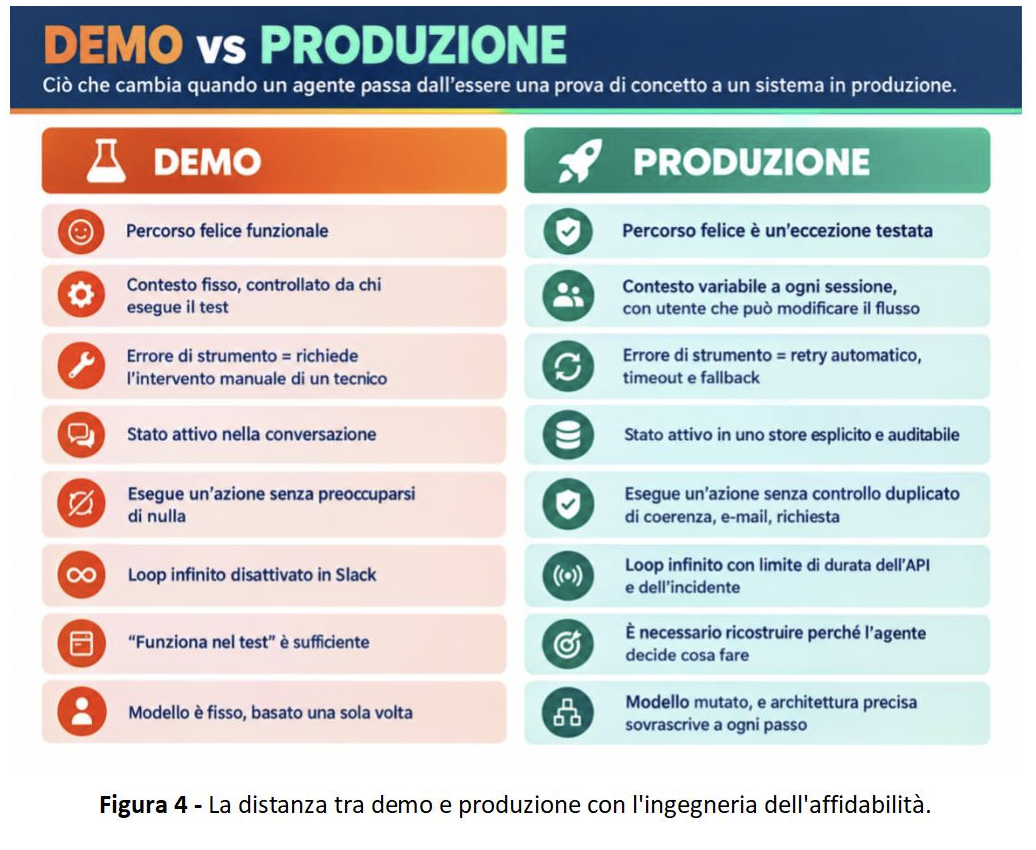
È facile sottovalutare questa distanza finché l’agente gira solo contro i casi di test di chi lo ha costruito. Il contrasto diventa chiaro quando si mette a confronto ciò che è tollerabile in una dimostrazione con ciò che è richiesto a un sistema in produzione, con utenti reali, denaro reale e conseguenze reali per ogni decisione.
 FinOps per l’IA: misurare e controllare il costo della scala
Ogni agente che chiama un modello ha un costo per esecuzione, e questo costo, a differenza della maggior parte dell’infrastruttura tradizionale, varia in base al comportamento del sistema stesso: un agente che entra in loop, che usa un modello più grande di quanto richieda il compito, o che rielabora ripetutamente lo stesso contesto può moltiplicare la fattura senza che nessuno abbia cambiato una sola riga di configurazione. Il FinOps per l’IA applica la stessa disciplina che già conosciamo dal cloud, visibilità, ottimizzazione e governance, in un ciclo continuo, ora applicata a token, chiamate al modello ed esecuzioni di agenti. Visibilità significa costo allocato per agente, per team e per caso d’uso, non solo una fattura consolidata del provider. Ottimizzazione significa scegliere il modello giusto per ogni compito (non ogni chiamata richiede il modello più costoso disponibile), applicare cache dei prompt, batching delle richieste e limiti di contesto. Governance significa budget per squad, alert di consumo e, il punto più importante per le architetture agentiche, budget guardrail incorporati nell’agente stesso, che interrompono l’esecuzione prima che il costo sfugga di mano, esattamente come discusso nella domanda sui limiti dei loop.
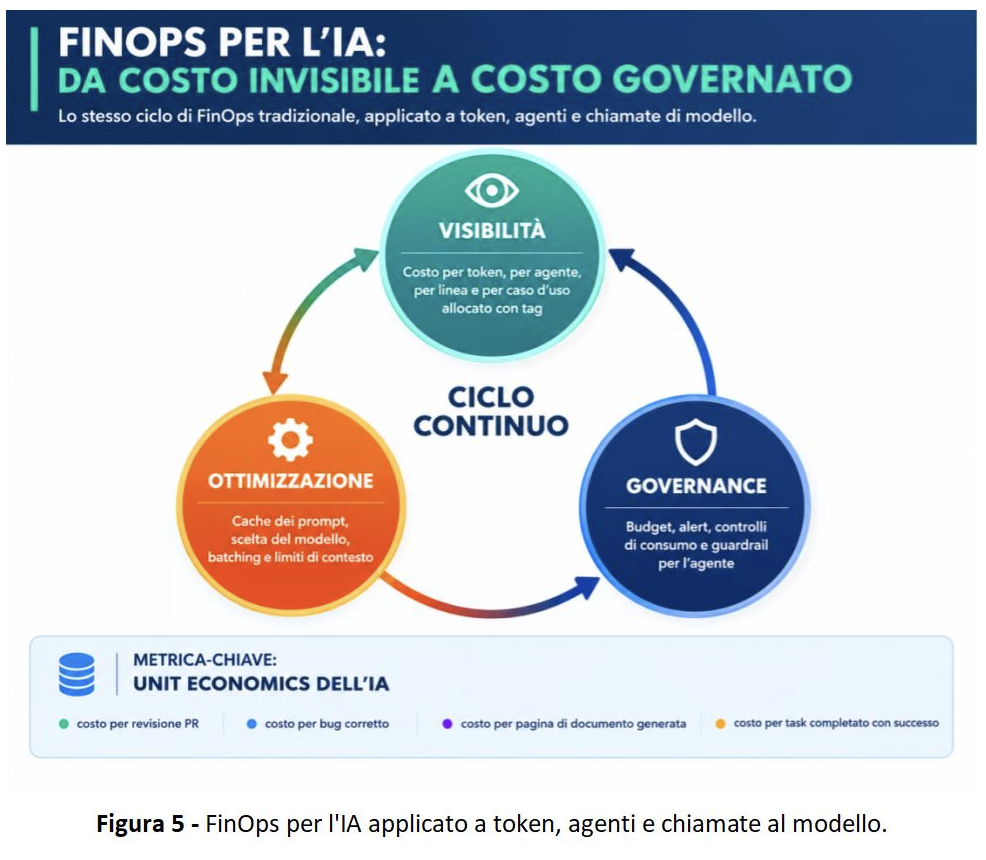 La maturazione di questa disciplina richiede un cambio di metrica: invece di monitorare solo la spesa totale in IA, i team maturi monitorano l’unit economics, costo per pull request revisionata, costo per bug corretto, costo per pagina di documentazione generata, costo per attività completata con successo. Questo è il numero che collega effettivamente l’investimento in IA al risultato ingegneristico, ed è la base per qualsiasi conversazione sul ROI con la leadership esecutiva.
Dall’esperimento alla scala: maturità e governance
La distanza tra uno sviluppatore che usa un copilot per conto proprio e un’organizzazione con IA integrata e governata lungo tutto il ciclo di sviluppo non si percorre in un colpo solo: passa per stadi riconoscibili, ognuno dei quali richiede meno eroismo individuale e più piattaforma, dati e processo.
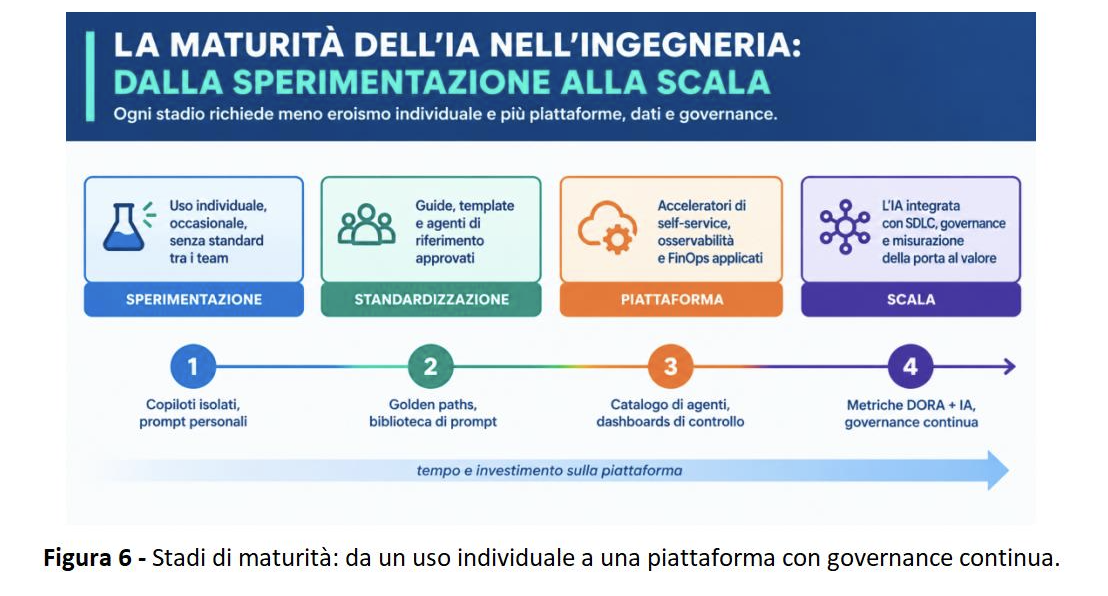
La maggior parte delle aziende oggi si trova tra i primi due stadi, sperimentazione dispersa e una prima standardizzazione, e il salto più difficile, ma più prezioso, è il terzo: trasformare buone pratiche isolate in una piattaforma con observability, FinOps e un catalogo di agenti riutilizzabili. È in questo stadio che la governance smette di essere un documento e diventa codice: policy applicate automaticamente, non ricordate manualmente.
Governance e standard come parte del prodotto, non come audit sucessivo
Definire standard, governance e buone pratiche per l’uso dell’IA in ingegneria funziona meglio quando è incorporato negli acceleratori che i team già usano, template di agenti con guardrail preconfigurati, pipeline di CI che già includono la validazione dell’output strutturato, policy di accesso ai dati sensibili applicate direttamente nel gateway dei modelli, piuttosto che quando esiste solo come checklist di compliance rivista dopo che il codice è già in produzione. Una governance che arriva tardi diventa attrito; una governance incorporata nella piattaforma diventa velocità con sicurezza.
La domanda che resta
Nessuno degli 8 fallimenti discussi nella prima parte di questo articolo è ipotetico. Ognuno di essi ha già fatto crollare, ritardato o reso più costoso un sistema agentic in produzione, spesso in modo silenzioso, finché l’incidente giusto non li ha resi visibili. E lo stesso vale per la sfida organizzativa discussa nella seconda parte: qualsiasi piattaforma di IA che scala senza visibilità sui costi, senza uno standard di governance e senza una metrica di impatto reale finisce, prima o poi, per trovare la propria versione di produzione rotta. Il prompt engineering resta importante. Ma è lo strato più facile da correggere dopo, e il più facile da testare prima. Gli strati intorno al modello e intorno allo sviluppatore, stato esplicito, guardrail, observability, retry e timeout, fallback, idempotenza, valutazione continua, regole deterministiche, FinOps, governance e Developer Experience, sono quelli che decidono se un agente, e se un’intera strategia di IA per l’ingegneria, sopravvivono al primo giorno difficile in produzione. Quale di questi fallimenti consideri il più pericoloso per un AI Agent in produzione? E, nella tua azienda, quale di questi sei fronti è più indietro rispetto agli altri? Vale la pena rifletterci prima della prossima riga di prompt scritta, prima della prossima riga di architettura disegnata, e prima della prossima decisione di investimento in una piattaforma di IA per l’ingegneria.
A cura di Lenildo Morais (M.Sc.): Project Manager, Stratega Cloud & IA, Specialista FinOps e Professore
